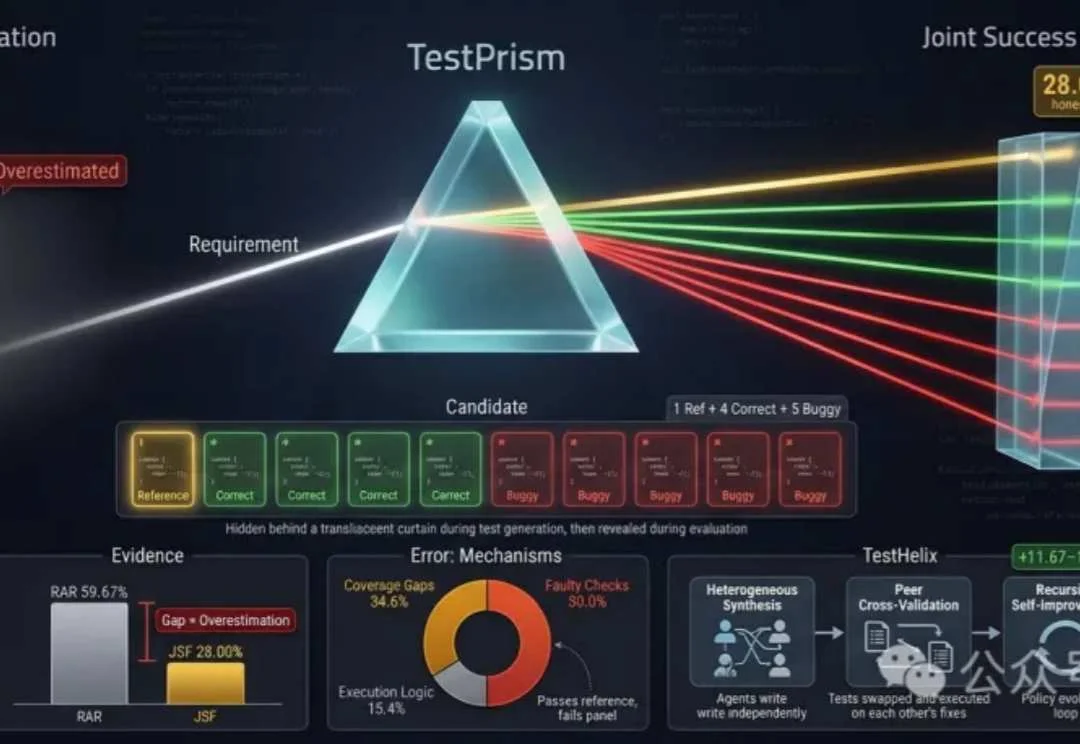
Coding agent写测试集体失败!AI代码合格率被高估一倍
Coding agent写测试集体失败!AI代码合格率被高估一倍Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
搜索
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
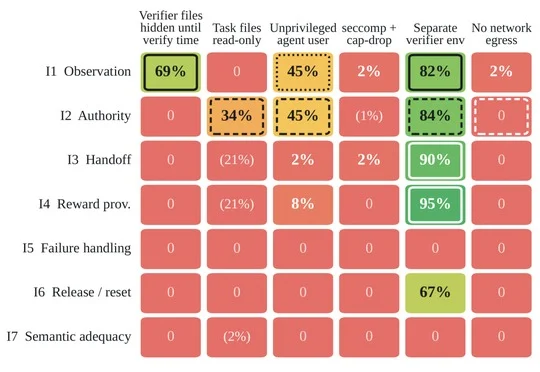
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
2026 年 3 月,轨道数据中心公司 Starcloud 宣布完成 1.7 亿美元 A 轮融资,由 Benchmark 与 EQT Ventures 领投,估值达到 11 亿美元,累计融资额达到 2 亿美元。
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
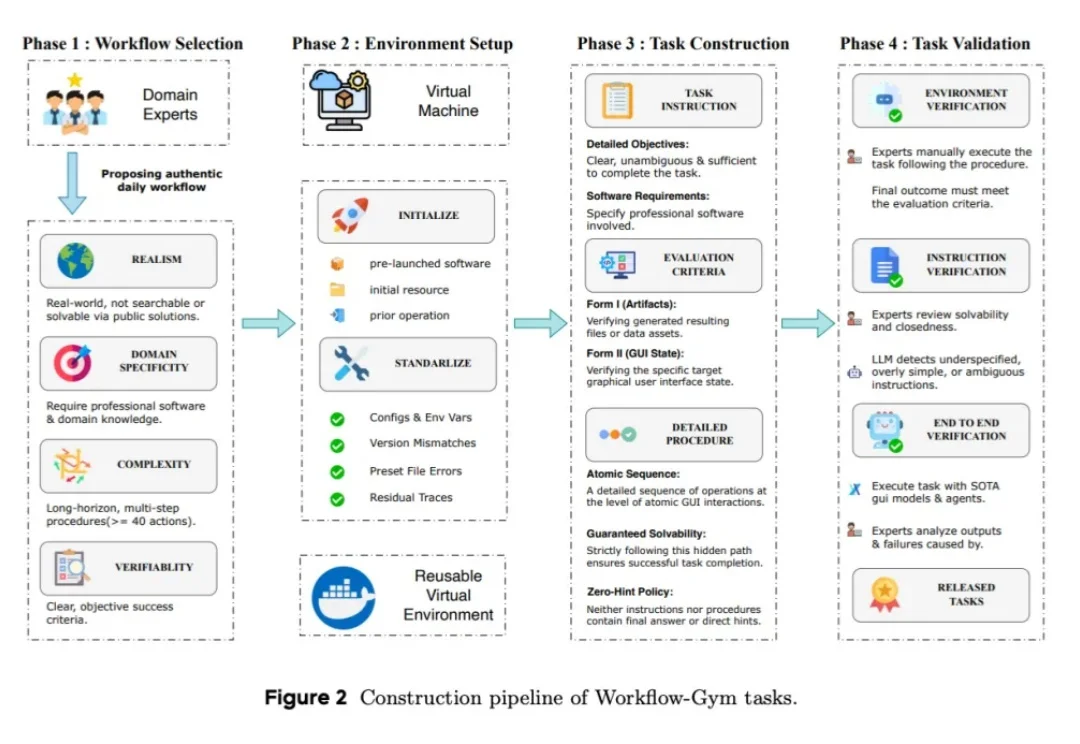
你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。
对 AI Coding 来说,有人用,比任何 Benchmark 都管用,而有人持续付费,又比有人用更管用。
今年开年以来,不管是硅谷、还是国内的 AI 投资圈子,都不太敢投 AI 应用了。
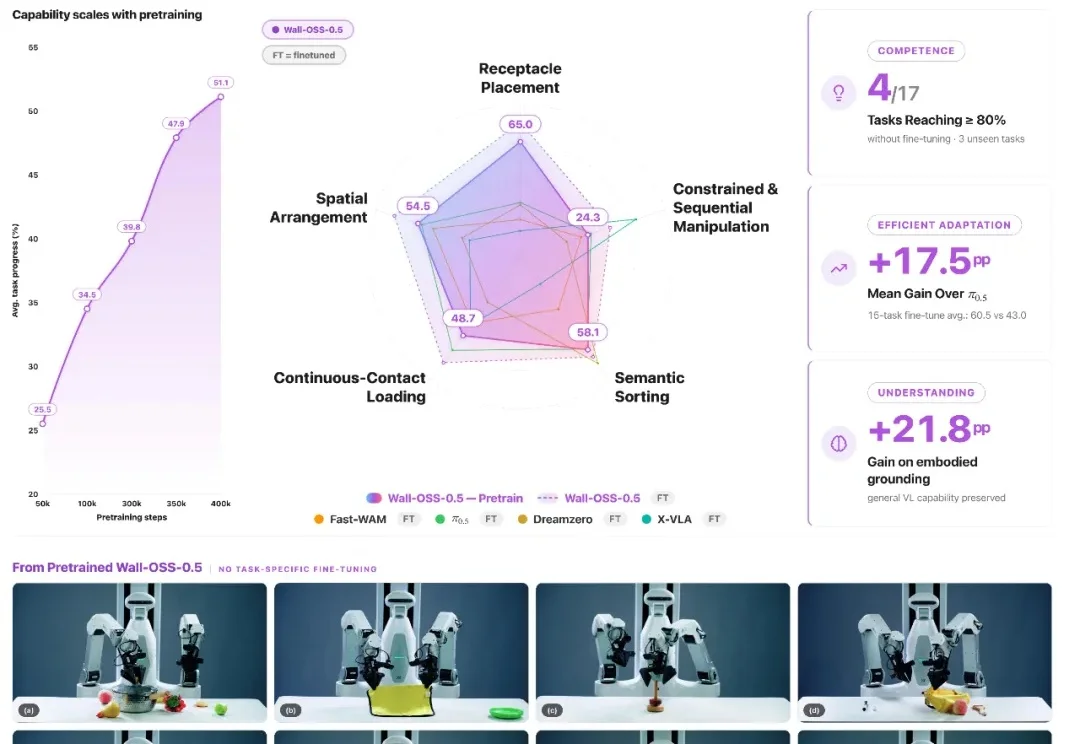
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。